TLDR:你多开窗口耍 cx/cx 效率极限在 10 个左右,而减少人类介入时间之后,可以达到 20 个
我们假设:
- 人类的注意力是 串行 的——你同一时刻只能专注一件事。
- AI Agent 是 并行 的——100 个 Agent 数量没有上限,跑起来互不干扰。
所以我们可以建模一下, 人类与AI协作的效率模型
你的注意力有限
想象你是一个餐厅经理,手下的厨师想要多少有多少。
如果你站在一个厨师背后盯着他切菜、炒菜、装盘,全程指挥。虽然你确实让这个厨师做得更好了,但你只有一双眼睛。
那开 20 个厨师呢?理论上你 2 分钟指导一个,刚好轮一圈。但问题来了:你从粤菜厨师走到日料厨师,脑子要从”镬气”切换到”刀工”,这个切换不是免费的。而且厨师越多,你记住每个人做到哪一步就越难。
到了第 25 个厨师,你光”想起来他在做什么”就要花 1 分钟,指导的 2 分钟反而没发挥作用。
这就是为什么优化任务效率的问题中,最优解不是”无限多 Agent”,而是存在一个极值。
公式来了
别被吓到,就三个东西:
- = 你同时跑的 Agent 数量,没有上限
- = 脑子切换的成本, 随 N 增大而增大。管 3 个 Agent 切换成本很低,管 20 个你光回忆上下文就耗尽了
- = 调度效率,范围是0-1, 随 N 增大而降低。Agent 越多,“3 个同时找你”和”全在跑没人需要你”的概率都在涨
注意到: 往上走, 在吃你, 在拖你。存在一个最优并行数, 超过它,再加 Agent 反而降低总产出。
不同的工作模式, 不同。你的基础设施越好, 越高。
五种工作方式,效率差多少?
Level 0:纯人类编码
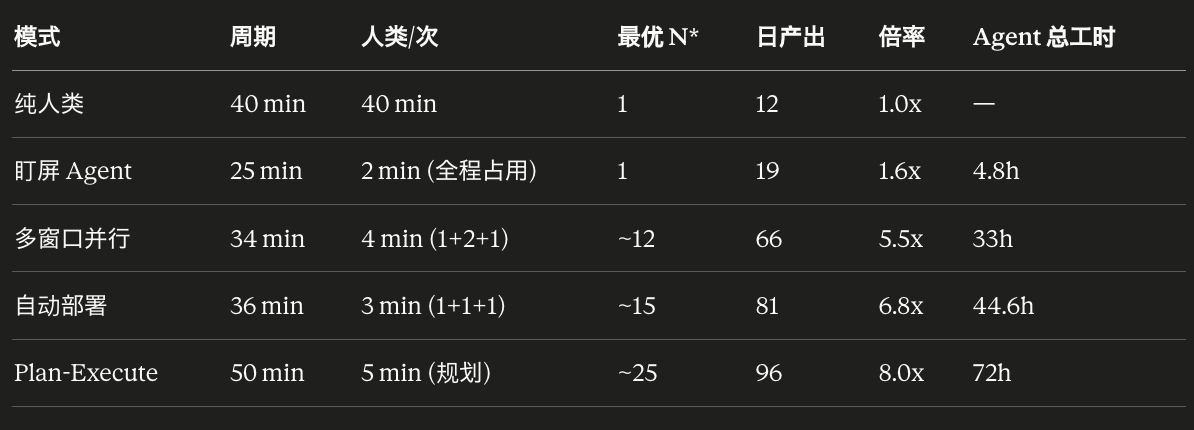
baseline:你自己写,40 分钟一个任务。一天 8 小时,完成 12 个。
Level 1:盯屏 Agent(绝大多数人的现状)
Agent 写 5 分钟,你放下刷视频的手机,花 2 分钟看一眼、敲个反馈,再等它写下一段。来回几轮,25 分钟一个任务。一天 19 个。
快了?快了。但只有 1.6 倍。因为你全程在盯着——Agent 写那 5 分钟你也占着,刷刷手机等它跑完。N = 1,没有并行。
Level 2:多窗口并行
你这次没玩手机,你给 Agent 更完整的上下文,让它能独立跑更久。每个任务你通常介入三次:
- 1 分钟 vibe 信息输入,Agent 启动工作一段时间。
- 2 分钟中间纠偏,因为你发现你的设想可能有偏差或者你表达有偏差,让他重新干
- 1 分钟收尾验收,共 4 分钟。
Agent 独立工作 30 分钟,周期 34 分钟。
理论上 N 可以开到很高,但随着窗口增多,你在”这个 Agent 改的是哪个模块来着?“上花的时间越来越多。
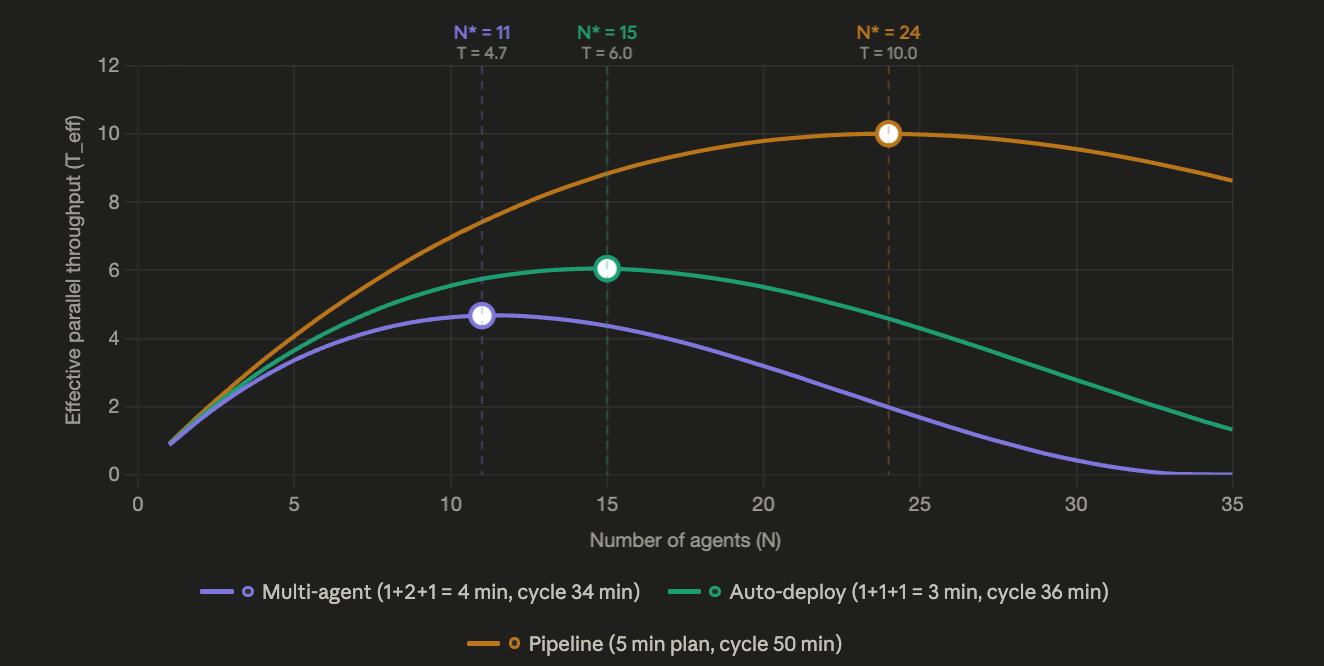
最优 ≈ 12,有效并行 4.7 倍。一天 66 个, 5.5 倍
理论值,这里没有给,实际上你可能早上刚喝完咖啡能够达到这个强度,下午就累完了。而且实际的并行会给你带来:不同端口的冲突,数据库冲突(Worktree 的并行实际还没法隔离完整的开发环境),你需要一个工具能够立马知道哪个Agent跑完了,
Level 3:自动化部署(省人类一分钟,多做 15 个任务)
用脚本自动化或者提示词或者 Harness Engineering 或者 CI,达到自动切分支/Worktree、跑测试、部署预览环境,达到点开预览链接就能看到效果。
中间那次纠偏从 2 分钟省到 1 分钟(你不再需要手动跑命令确认状态,Agent 自己搞定了)。人类介入变成 1+1+1 = 3 分钟
Agent 多自主跑 3 分钟,周期 36 分钟。
自动化只往前走了很小的两步:
- 让每次介入更短、更标准化,所以 α 增长更慢;
- Agent 自主运行时间更长,调度更平滑,η 衰减更慢。
**最优 ≈ 15,有效并行 6.1 倍。一天 81 个, 6.8 倍
Level 4: Plan → Execute → Deploy 流水线
最终的理想:把人类的角色从”过程中反复纠错”变成”开头花 5 分钟做好规划”。Agent 拿到清晰的 plan 后自主执行 45 分钟。全流程端到端,AI自动编码、测试、部署,全自动零打断。周期 50 分钟。
虽然前面的计划时,5 分钟比 3 分钟长,但其实就类似于Planning Mode,需要你花一定时间设计,跟AI沟通好需求,计划好之后再让 AI 开始干,完全handoff。
这 5 分钟的贡献在于:
- α 增长最慢:每次你做的事都是”规划”,认知模式统一,切换成本比较低
- η 衰减最慢:45 分钟的独立运行时间,调度几乎不存在冲突
- N* 被推到最高:你可以同时管理远多于其他模式的 Agent
最优 N* ≈ 25,有效并行 10 倍。一天 96 个任务 ——但每个任务比 Level 2 大 50%。
自动测试的时候,Harness Engineering 可以完善测试和各种代码规范,尽可能将代码推向可维护性高的方向发展(也免去后期经常清理代码的烦恼)。但是会带来:运行测试时间更长,Agent等待时间更久,并行高带来的合并冲突概率上升。
换算成 Agent 总工时: 72 小时。一个人的 8 小时,撬动了 9 倍的 AI 劳动力。
按照偏低的开销计算,高估最大值
| α(N) | η(N) | |
|---|---|---|
| Multi-agent | 0.02 + 0.025 × N | 0.95 − 0.025 × N |
| Auto-deploy | 0.02 + 0.020 × N | 0.95 − 0.020 × N |
| Pipeline | 0.01 + 0.015 × N | 0.95 − 0.012 × N |
Claude 提供了下面的图表:

个人实践
假如说个人希望能够提高效率,减少切换上下文带来的大脑疲惫的感觉,可以尝试几个点。
回想你最近的做的项目:
- 是否有每次都提,但是代码规范没落地,需要你每次介入手动改的?
- 是否有审核 PR 的时候,切分支,开服务打断你当前工作的?
- 是否经常”轮询”各个终端窗口,看哪个Agent跑完没的?
- 是否有Agent说做完了,但是一启动炸了,你手动找报错日志给 Agent,Agent 问你要不要改,你回 OK 他才去改的?
上述各类情况都需要正确配置 Skills,Harness Engineering 来解决,最大化 Agent 连续工作时间,最小话人类介入时间,才能达到效率最优。
- 规范你与Agent交互的方式,先 Plan再Execute能够提高很多效率。而且写完再修改消耗2倍token。尽可能让 Agent 在你的项目里面达到一击命中的感觉。(后端大概率可以,前端仍然缺少有完美品味以及测试方式让 Agent 100%达到你的需求,毕竟文本难以描述图像)
- 给你的 Agent 配置 Skill,无论如何都要实现完成即部署,剩下你1分钟的打断时间。
- 做好测试,将你的需求转化为测试,避免回归,避免描述不准确。测试对Agent来说是绝对的第二信源。(第一信源是你的prompt),如果让需要被修改的代码作为信源,会导致很多混乱!
- tmux或者 zellij 多开窗口,而不是用vscode的terminal。实时查看进展,避免轮询。
我自己在使用 OpenASE 完成这个过程,自己也在摸索当中:
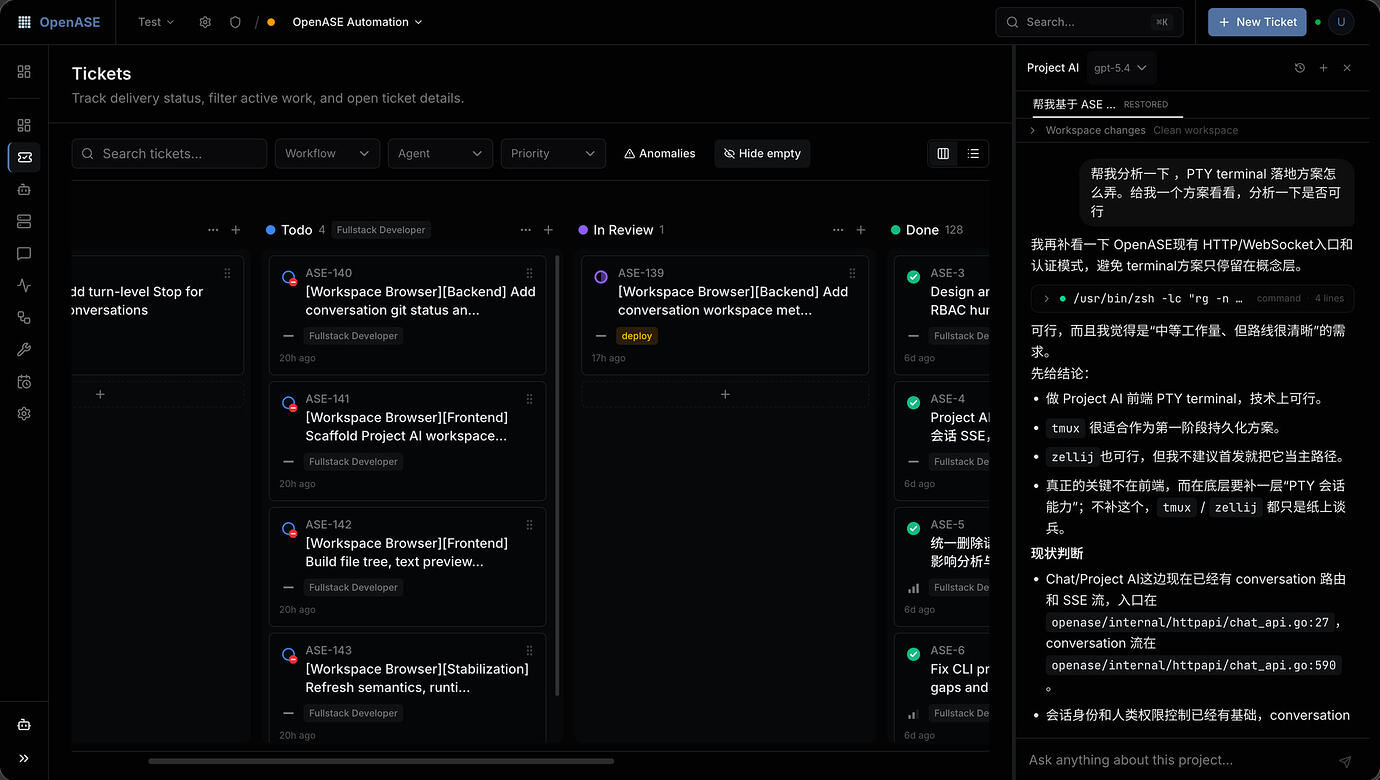
状态设计:Todo 放后端任务,Frontend 放前端任务。额外增多 Preview Deploy 在 Coolify 环境中部署独立的服务供我测试前端交互以及基本逻辑正确。
Workflow设计:后端使用 Codex,前端使用 Claude Code,一个 ticket 直接流转:
- 后端开发者(Codex+后端测试,Domain 100%覆盖率):Todo->In Progress->Frontend
- 前端开发者(Claude code+DESIGN.md Skill):Frontend->Frontend In Progress->Preview Deploy
- 部署运维员(Codex加Coolify Skill):Preview Deploy->In Review
- 人类(大脑):In Review->Merging,不通过放到 Rework
- 合并(Codex):Merging->Done
Omx 也可以这么玩:
- $deep-interview → 需求澄清
- $ralplan → 方案审批
- $ralph → 单一负责人持续推进
- $team → 并行团队执行